Navegación facetada y SEO: cómo gestionar los filtros de URL sin desperdiciar rastreo
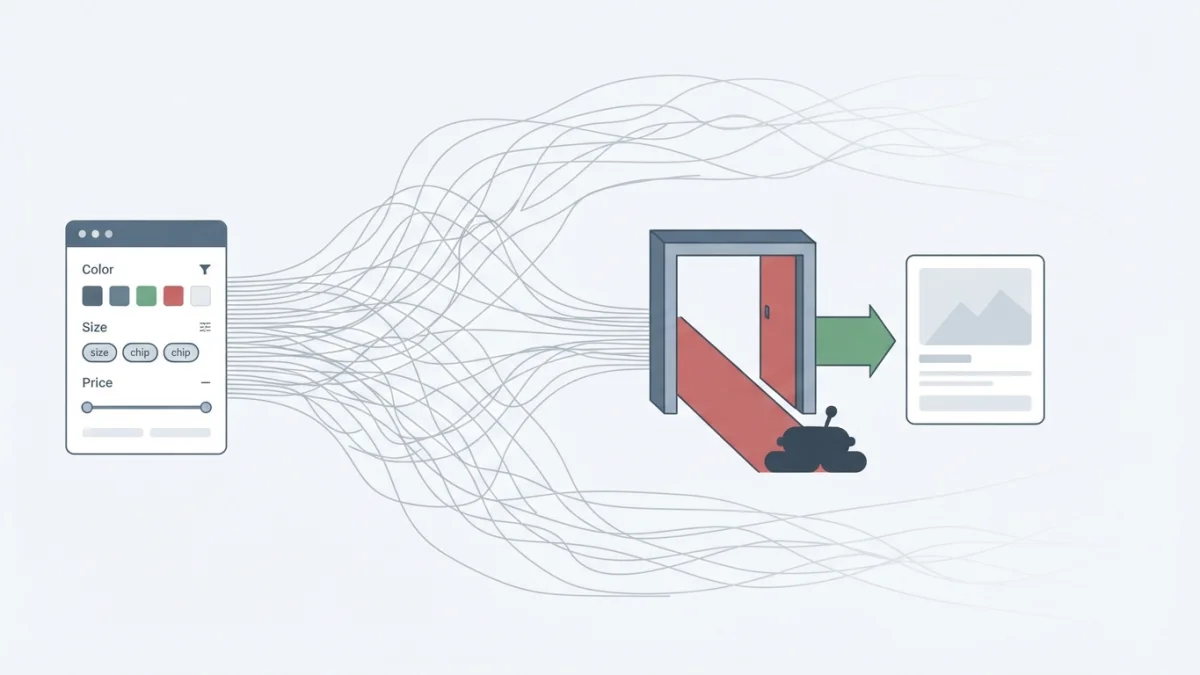
Tabla de contenidos
Ordenar por precio, filtrar por talla o por color: cada clic crea una URL nueva. Google lo dice sin rodeos: la navegación facetada es la causa más común de sobre-rastreo que reportan los dueños de sitios. Aquí ves cómo decidir cuáles merecen existir sin desperdiciar rastreo.
Qué es la navegación facetada y por qué multiplica las URLs
Es la función que permite al visitante cambiar cómo se muestran los elementos de una página (productos, artículos, eventos) aplicando filtros sobre sus propiedades. Una URL típica acumula parámetros, por ejemplo ?products=fish&color=radioactive_green&size=tiny: cambia cualquier valor y verás otros elementos, otra URL.
La aritmética explica el problema: con diez valores por faceta y cuatro facetas, las combinaciones se cuentan por miles, y no son páginas que alguien decidió crear, sino permutaciones del sistema. Google las describe como espacios de URLs prácticamente infinitos en su guía sobre gestionar el rastreo de URLs de navegación facetada.
Las dos consecuencias: sobre-rastreo y descubrimiento lento
En el sobre-rastreo (overcrawling) las URLs de facetas parecen nuevas y el rastreador no sabe si sirven hasta descargarlas, así que accede a muchísimas URLs inútiles. El descubrimiento más lento es la otra cara: el tiempo gastado ahí no se dedica a las páginas nuevas y útiles.
Y ojo con el coste: rastrear facetas consume gran cantidad de cómputo del servidor y compite con el límite de capacidad del rastreador (presupuesto de rastreo).
La decisión previa: ¿necesitas que esas URLs se indexen?
Google plantea dos caminos y hay que elegir antes de tocar código: si no necesitas esas URLs, impide su rastreo; si sí las necesitas, cúmplelas con las buenas prácticas y asume el coste.
El criterio es de negocio: una combinación merece ser página propia solo si hay demanda de búsqueda real o si el negocio la necesita para una campaña. Todo lo demás multiplica URLs sin traer tráfico.
Cómo detectar las combinaciones con demanda real
Busca la consulta como la escribiría una persona ("zapatillas de running talla 42"), no el nombre técnico del atributo. La evidencia sale de Search Console, Google Trends y tu herramienta de keywords. Y una nota de sensatez: las combinaciones de dos o más facetas casi nunca tienen volumen; el valor está en categoría más un atributo. Cruza esto con tu método de keyword clustering y con la lógica de las palabras clave de long tail.
Si no las necesitas: bloquear el rastreo
La vía principal es robots.txt con patrones de parámetro: Google dice sin adornos que a menudo no hay buena razón para permitir el rastreo de elementos filtrados, porque consume recursos a cambio de un beneficio nulo o insignificante.
Patrones de parámetro en robots.txt
User-agent: *
disallow: /*?*products=
disallow: /*?*color=
disallow: /*?*size=
allow: /*?products=all$
La excepción con allow importa tanto como los bloqueos: si una URL útil usa el mismo parámetro, déjala accesible con una regla más precisa, porque gana la más larga. La otra cara: una URL bloqueada permanece en la cola de rastreo mucho más tiempo, así que robots.txt no "olvida" URLs. Sintaxis completa en la guía de robots.txt.
Filtros con fragmentos (#): el atajo que Google ignora
La documentación propone codificar los filtros como fragmento de URL en lugar de parámetros, y funciona porque Google Search no soporta fragmentos ni en rastreo ni en indexación: no tienen impacto alguno. El matiz: esas combinaciones nunca serán indexables ni podrá mostrarse la página filtrada; si cambias el contenido con JavaScript, la vía oficial es la History API. Es un atajo válido solo cuando no quieres que nada de eso aparezca en búsqueda.
Canonical y nofollow: ayudan, tardan, no son intercambiables
Un rel="canonical" hacia la versión sin filtros puede reducir con el tiempo el rastreo de las variantes, pero la señal "tarda en recogerse": no es un interruptor. Y rel="nofollow" debe aplicarse en todos los enlaces que apunten a esa URL, internos y externos, o se pierde. Google califica ambos como menos efectivos a largo plazo que robots.txt o los fragmentos.
Si sí las necesitas: dejar las facetas en condiciones
Cuando una combinación merece existir como página, tres reglas técnicas evitan duplicados absurdos.
Separador y orden de los parámetros
Usa el separador estándar &: comas, punto y coma y corchetes son difíciles de detectar como separadores. Y si las facetas van en la ruta (/products/fish/green/tiny), el orden debe ser siempre el mismo y sin filtros duplicados, para que color=rojo&talla=42 y talla=42&color=rojo no convivan como dos URLs.
Devolver 404 de verdad cuando no hay resultados
Sin peces verdes en el catálogo, devuelve un HTTP 404 correcto, también con filtros duplicados y paginaciones inexistentes. No redirijas a una página genérica de "no encontrado": sirve el 404 en la URL donde ocurrió (salvo aplicaciones de página única). Las soft 404 se siguen rastreando y gastan presupuesto, como explica el artículo de errores 404 y soft 404.
Cada combinación indexable debe parecer una página
Necesita contenido propio: título y h1 que nombren la combinación, un párrafo de contexto útil y migas de pan. Un listado reciclado de la categoría padre no basta. El canonical debe acompañar la decisión: si se indexa, autorreferencial. Y en el sitemap incluye solo esas combinaciones, nunca todas las facetas.
robots.txt, noindex y 404/410 no hacen lo mismo
noindex no ahorra rastreo
La documentación de presupuesto de rastreo lo dice explícitamente: no uses noindex aquí, porque Google igual solicita la página y solo después la descarta al ver la etiqueta, gastando tiempo de rastreo. Con miles de URLs de facetas, un noindex masivo no reduce la carga del servidor. Tampoco sirve para elegir canónica dentro del mismo sitio, porque bloquea la página por completo. Detalle en meta robots y noindex.
robots.txt no sirve para canonicalizar
Google puede seguir indexando URLs bloqueadas sin su contenido, sobre todo si hay enlaces externos apuntando a ellas. Por eso, si una URL facetada ya está indexada, bloquearla no la quita y además impide leer su noindex: el bloqueo se decide antes de que las URLs se conozcan. Si ya están indexadas, necesitas noindex con la página rastreable o un 404/410.
404/410 sí saca URLs de la cola
Google no olvida una URL que conoce, pero un 404 es una señal fuerte para no volver a rastrearla, mientras que las bloqueadas se quedan en la cola mucho más tiempo; un 410 confirma que la eliminación es definitiva. En facetas: combinaciones retiradas, 404/410, nunca un bloqueo silencioso.
| Situación | Herramienta correcta |
|---|---|
| Nunca la conocí y no la quiero | robots.txt |
| Fuera del índice, pero puede estar rastreada | noindex (y nunca bloquearla a la vez) |
| Ya no existe | 404 o 410 |
| Duplicados de una versión buena | rel="canonical" (y redirecciones, la señal más fuerte) |
Cómo verificarlo en Search Console y en los logs
El informe de Indexación de páginas lista los motivos de exclusión típicos ("Duplicada: el canonical elegido por Google es otro", "Rastreada: actualmente no indexada"): cuenta cuántas de esas URLs son filtros. Las Estadísticas de rastreo dan peticiones por tipo y por código de respuesta, y un pico de URLs con parámetros es la huella del sobre-rastreo.
Cruza eso con los logs del servidor: si la proporción de peticiones a facetas frente a producto es alta, ahí está el presupuesto que se gasta. La Inspección de URL permite probar tres o cinco URLs a mano (una indexable, una bloqueada, una vacía) y comprobar el canonical elegido. Y recuerda el coste de servidor: caché HTTP y respuestas 304.
Errores frecuentes en tiendas y catálogos
- Indexar todas las permutaciones "por si acaso": sobre-rastreo y canibalización con la categoría padre.
- Creer que un
noindexmasivo ahorra rastreo, o combinarlo con un bloqueo en robots.txt (la etiqueta nunca se lee). - Dejar parámetros de ordenación, vista, moneda, sesión o seguimiento.
- Mantener un orden de filtros inconsistente en la ruta.
- Devolver 200 con un listado vacío o redirigir a una página genérica.
- Bloquear una combinación que sí tiene demanda, o dejar indexadas las que compiten con la categoría.
- Meter facetas en el sitemap: incluirlas es pedir que se rastreen.
- Olvidar la paginación dentro de las facetas.
- No medir nunca: el bloqueo se queda años y el destrozo aparece cuando cae el tráfico.
Plan de implementación en 7 pasos
- Inventario: facetas, valores y combinaciones que el catálogo genera hoy.
- Marca las combinaciones con demanda; el resto son permutaciones.
- Escribe las reglas de robots.txt con patrones de parámetro y excepciones
allow. - Programa el 404 real para combinaciones vacías y paginaciones inexistentes.
- Estandariza el separador
&y el orden de filtros, y elimina parámetros que no cambian el contenido. - Añade contenido mínimo a las combinaciones indexables y ajusta el sitemap.
- Verifica a las 2-4 semanas en Search Console y cierra con este checklist.
Las facetas son una gran función de usabilidad: el trabajo no es eliminarlas, sino decidir cuáles merecen existir y que Google no gaste ahí su presupuesto. Si el problema de fondo es cuánto rastrea tu sitio, empieza por el artículo de presupuesto de rastreo.